-- table: architect
个人信息
张勇
资深数据架构师
-- 画像查询
> SELECT experience, scale, focus FROM architect;▍
experience
15 年
scale
PB 级数据平台
focus
数据治理 × Agent
1 row in set (0.003 sec)
- ·15年数据架构与数仓建设经验,主导过 PB 级数据平台、实时数仓与公司级数据中台建设。
- ·擅长数据治理、数据建模与数据团队管理,曾管理 15 人数据技术团队。
- ·深度实践 LLM 应用与 Agent 架构设计,完成数据治理 Agent PoC,并将日常建模、数据纠错、质检等流程沉淀为 Skill + 工作流的 AI 数据开发模式。
> SHOW TABLES;
7 rows in set (0.001 sec)
-- table: work_experience
工作经历
独立研究与项目实践(AI / 机器人方向)
- 通过吴恩达(DeepLearning.AI)与 Stanford 在线课程系统学习 LLM 应用与 Agent 架构(Prompt Engineering、RAG、Function/Tool Calling),并以开源项目完成工程验证
- 独立开发 TransNotes:AI 视频学习笔记 Chrome 扩展,实现 YouTube/B 站视频实时翻译配音、时间戳笔记与截图标注、AI 概览与多模板学习笔记生成,一键导出 Obsidian(github.com/zyjarge/TransNotes)
- 独立开发智能求职助手 job-hunter-assistant:覆盖职位抓取、分析与求职流程管理的全栈 AI 应用(github.com/zyjarge/job-hunter-assistant)
- 在去哪儿工作期间,自学 OpenCV 计算机视觉相关知识,实现用户上传照片的自动打标签与分类统计
- 面向仓储 AGV 提效方案中的数据采集与执行监控需求,自学 ROS 机器人系统:掌握节点通信(Topic/Service/Action)、TF 坐标变换、多传感器数据接入等核心机制,理解端侧数据产生方式、拓宽工程视野,与数据链路形成闭环
- 上述实践形成的 Agent 工程方法论,成为后续数据工作流智能体项目的技术底座
华耐家装
资深数据架构开发负责公司各业务线的数据开发工作,并作为 AI 开发布道者推动 AI 在数据团队落地。
- 数据工作流上线后,数据需求平均交付周期从 5-10 天缩短至 2 天,业务自助取数占比提升至 50%,数据团队从重复取数中释放约 50% 人力投入高价值分析
- AI 数据开发模式使新需求的人均交付成本显著下降,同等人力下支撑的业务线数量从人均 1-2 个提升至 4-5 个
- 从 0 到 1 搭建公司数据开发工作流,覆盖数据建模、代码开发、工作流编排、数据质量监控、数据治理等各个环节
- 将 AI Agent 应用到数据开发工作流各环节:设计并实现数据治理 Agent,覆盖元数据自动标注、血缘/影响分析、智能问数(Text-to-SQL)等场景
- 完成 PoC 验证:覆盖 200+ 核心表的元数据自动标注,标注准确率 85%+,智能问数日均为 20+ 名数据团队成员提供服务
- 将日常建模、数据纠错、数据质检等操作抽象为可复用 Skill,通过工作流编排纳入日常数据开发流程
- stack: Airflow + dbt + OpenMetadata + DataX + Grafana + Prometheus | LLM(Codex/DeepSeek 等)+ Prompt Engineering + Function/Tool Calling
去哪儿旅行
资深数据架构师- 数据中台统一集团数据口径,跨业务线的数据争议与重复开发显著减少,数据需求平均交付周期从 3 周缩短至 1-2 周
- 实时数据平台直接支撑订单监控与营销决策场景,大促期间为业务提供秒级决策依据,支撑单日百万订单量级的稳定运行
- 主导设计并实现公司级数据中台建设,服务 100+ 业务线,日均处理数据量 10TB+,支持实时数据分析和决策
- 设计实现实时数据处理平台,基于 Flink + Kafka 构建,处理延迟<5s,支撑订单、用户行为等高并发场景
- 推进数据治理项目,基于 Atlas + OpenMeta 构建数据资产管理平台,数据使用效率提升 200%,运维成本降低 40%
- 主导数据架构升级,引入 Data Vault 2.0 模型,提升数据加工效率 50%,数据一致性达到 99.9%
北京风行视频有限公司
数据中心高级经理- 实时用户画像系统直接驱动广告投放效率,广告转化率提升 35%,对应年化广告增收约 20%
- 统一数据平台建成后,各业务线重复报表开发减少,数据团队人效提升 80%
- 搭建公司统一数据平台,整合 7+ 业务系统数据,日均处理 PB 级数据,支持千万级用户数据分析
- 设计并实现实时用户画像系统,基于 Spark Streaming 构建,支持秒级标签更新
- 主导数据仓库重构,采用 Lambda 架构,优化查询性能提升 8 倍,支持亿级数据秒级查询
- 管理 15 人技术团队,建立数据开发规范和评审机制
亚信(中国)技术有限公司
高级工程师- 负责中国移动省级数据仓库建设,日均处理话单数据 3 亿+,查询性能提升 5 倍
- 设计实现用户行为分析平台,支持亿级用户精准营销,营销转化率提升 40%
- 主导 ETL 框架优化,处理效率提升 3 倍,支持增量更新和实时计算
先合泰科(ATI)科技技术咨询有限公司
后端开发工程师- 美资企业离岸研发中心,基于客户业务需求开发和维护业务应用
- 技术栈:Java, Spring + Struts + Hibernate, Seam
无限立通通讯技术有限公司
后端开发工程师- 负责 Pushmail 移动网关(GEGW)的开发与设计
- 技术栈:Java, Spring + Struts + Hibernate, Oracle
-- table: project_records
项目经历
数据语义底座
- 指标语义层:指标字典与口径管理、维度与粒度定义、同名口径冲突仲裁
- 元数据管理:表结构与字段注释自动补全、数据血缘图谱、业务术语与黑话映射
- 知识库(RAG):开发规范与表使用文档入库、向量检索与重排序、知识更新与过期治理;自动识别用户上传的图片类文档并进行 OCR 解析,将转换后的文本统一纳入知识库检索
- 数据权限语义:行级/列级权限规则、敏感字段识别与脱敏、可申请权限的引导流程
智能工具层
- 数据开发工具:需求输入后自动分析知识图谱,定位所需上游依赖表,一次生成数据接入(DataX)与数据管道代码(dbt),并在 dbt 中同步注入数据质量验证逻辑
- Text-to-SQL:SQL 生成与方言适配、执行前 dry-run 校验、结果解读与摘要生成
- 数据质量工具:质量规则自动配置、异常数据探测与归因、质量报告解读
- 运维诊断工具:失败日志分析与根因定位、自动重跑/补数建议、SLA 风险提前预警
- 可视化工具:图表类型智能推荐、看板/大屏自动生成、截图与报告导出
家装行业业务线多、数据需求碎片化,传统数据开发「需求排期长、口径对齐难、质量靠人肉」的矛盾突出。为此设计并实现数据工作流智能体:以统一的数据语义底座(指标语义、元数据、RAG 知识库、权限语义)让 Agent 先「读懂业务」,再通过五类智能工具将 AI 能力嵌入数据开发全链路——需求输入后自动分析知识图谱、定位上游依赖表,一次生成 DataX 数据接入与 dbt 管道代码并注入质量验证逻辑,配合质检、运维诊断与可视化工具,实现「需求进、数据出」的端到端智能化。
项目成果
- 智能问数(Text-to-SQL)准确率 85%+,日均为 20+ 名数据团队成员提供服务
- 元数据自动标注覆盖 200+ 核心表,大幅降低元数据维护成本
- 日常建模、数据纠错、质检等操作沉淀为 Skill + 工作流,纳入日常数据开发流程
- 运维故障根因定位时间从小时级缩短至分钟级
技术栈
AI:LLM(Codex/DeepSeek 等), Prompt Engineering, Function/Tool Calling, RAG, 向量检索, OCR数据平台:Airflow, dbt, OpenMetadata, DataX监控告警:Grafana, Prometheus开发语言:Python, SQL
数据工作流体系
- 设计统一的数据开发工作流,覆盖任务开发、调度编排、发布审批、运维监控全链路
- 建立多业务线共用的任务规范与依赖管理标准,沉淀标准化开发模板 30+ 套
治理平台与元数据
- 基于 Atlas + OpenMetadata 构建数据资产管理平台,统一元数据采集、数据地图与检索能力
- 实现全链路数据血缘解析(表级 + 字段级),支撑变更影响分析自动评估
数据可视化集成
- 集成可视化分析能力,为业务提供自助式报表与看板,覆盖 20+ 业务主题
数据合规与风控审查
- 建立数据分类分级与敏感数据识别机制,落地访问审批与权限管控流程
- 设计数据使用审查机制,满足集团数据合规与风控审计要求
面向集团多业务线数据孤岛、研发流程分散、合规要求升级的背景,从 0 到 1 设计并落地集团数据中台,将数据工作流、元数据与血缘、数据治理、可视化集成、合规审查统一到一个平台体系,实现数据资产的可管、可控、可追溯。
项目成果
- 数据中台服务集团 100+ 业务线,日均处理数据量 10TB+,支撑实时分析与决策
- 数据使用效率提升 200%,数据资产运维成本降低 40%
- 血缘覆盖 90% 核心任务,变更影响评估时间从小时级缩短至分钟级
- 通过合规审查机制,支撑集团顺利通过 3 次数据安全审计
技术栈
实时计算:Flink, Kafka数据存储:Hive, Spark数据治理:Atlas, OpenMetadata调度编排:Airflow监控告警:Grafana, Prometheus开发语言:Java, Python, SQL
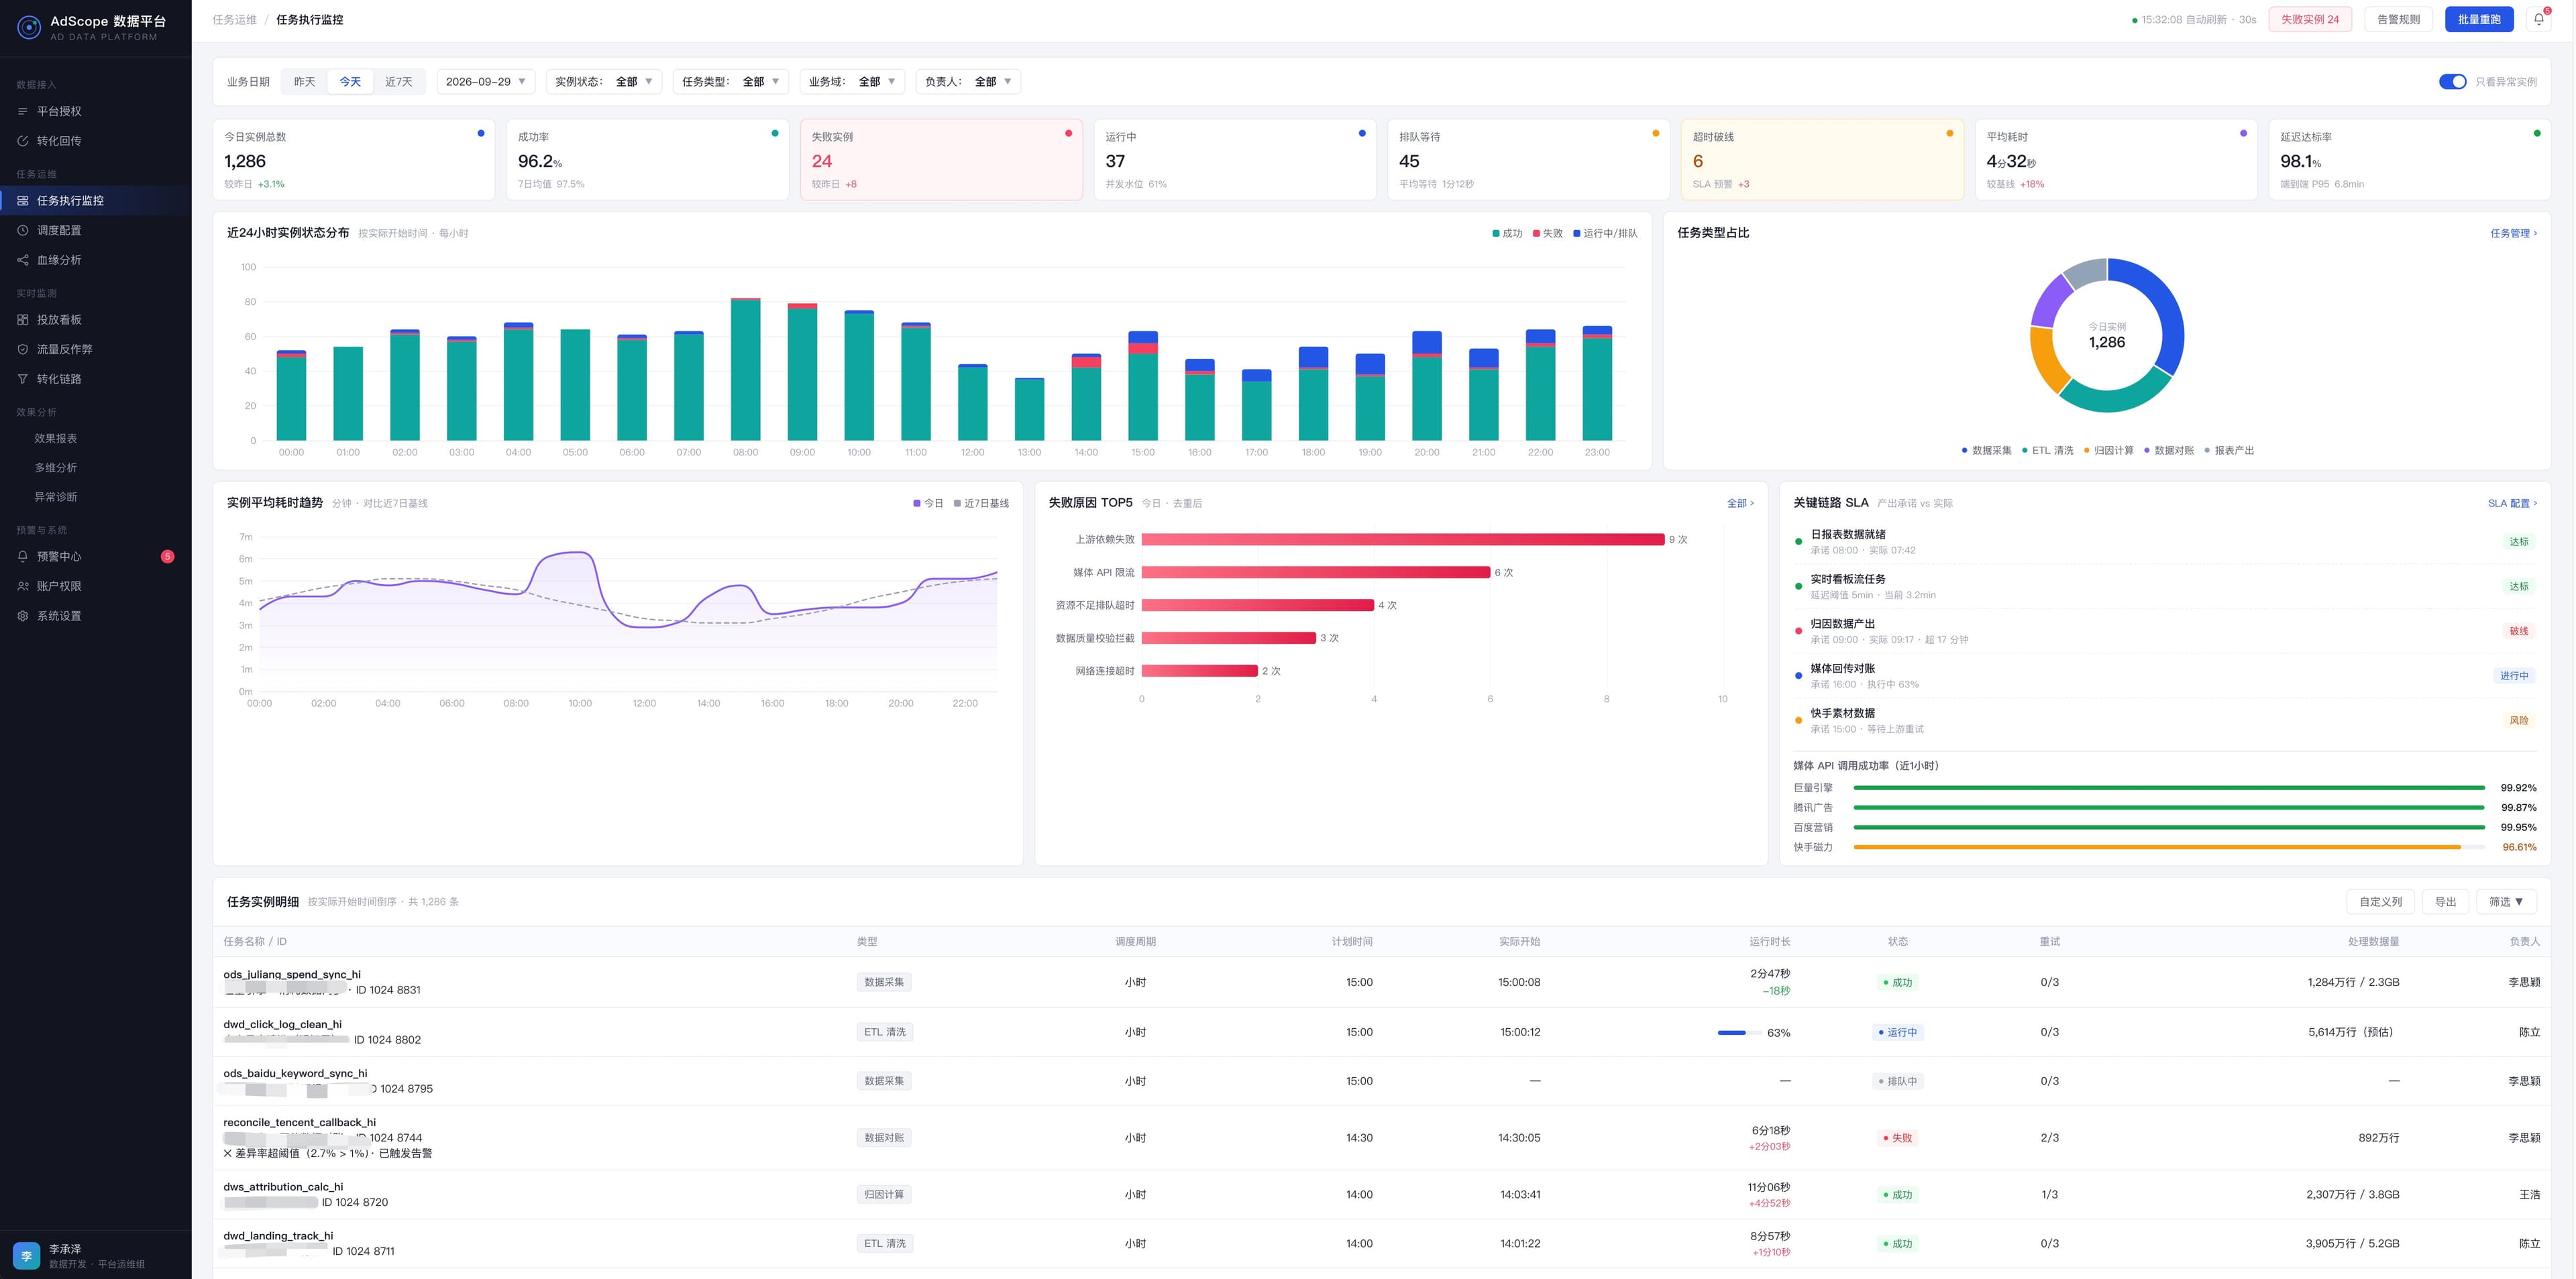
广告投放监控系统:任务实例状态、失败归因与关键链路 SLA 监控
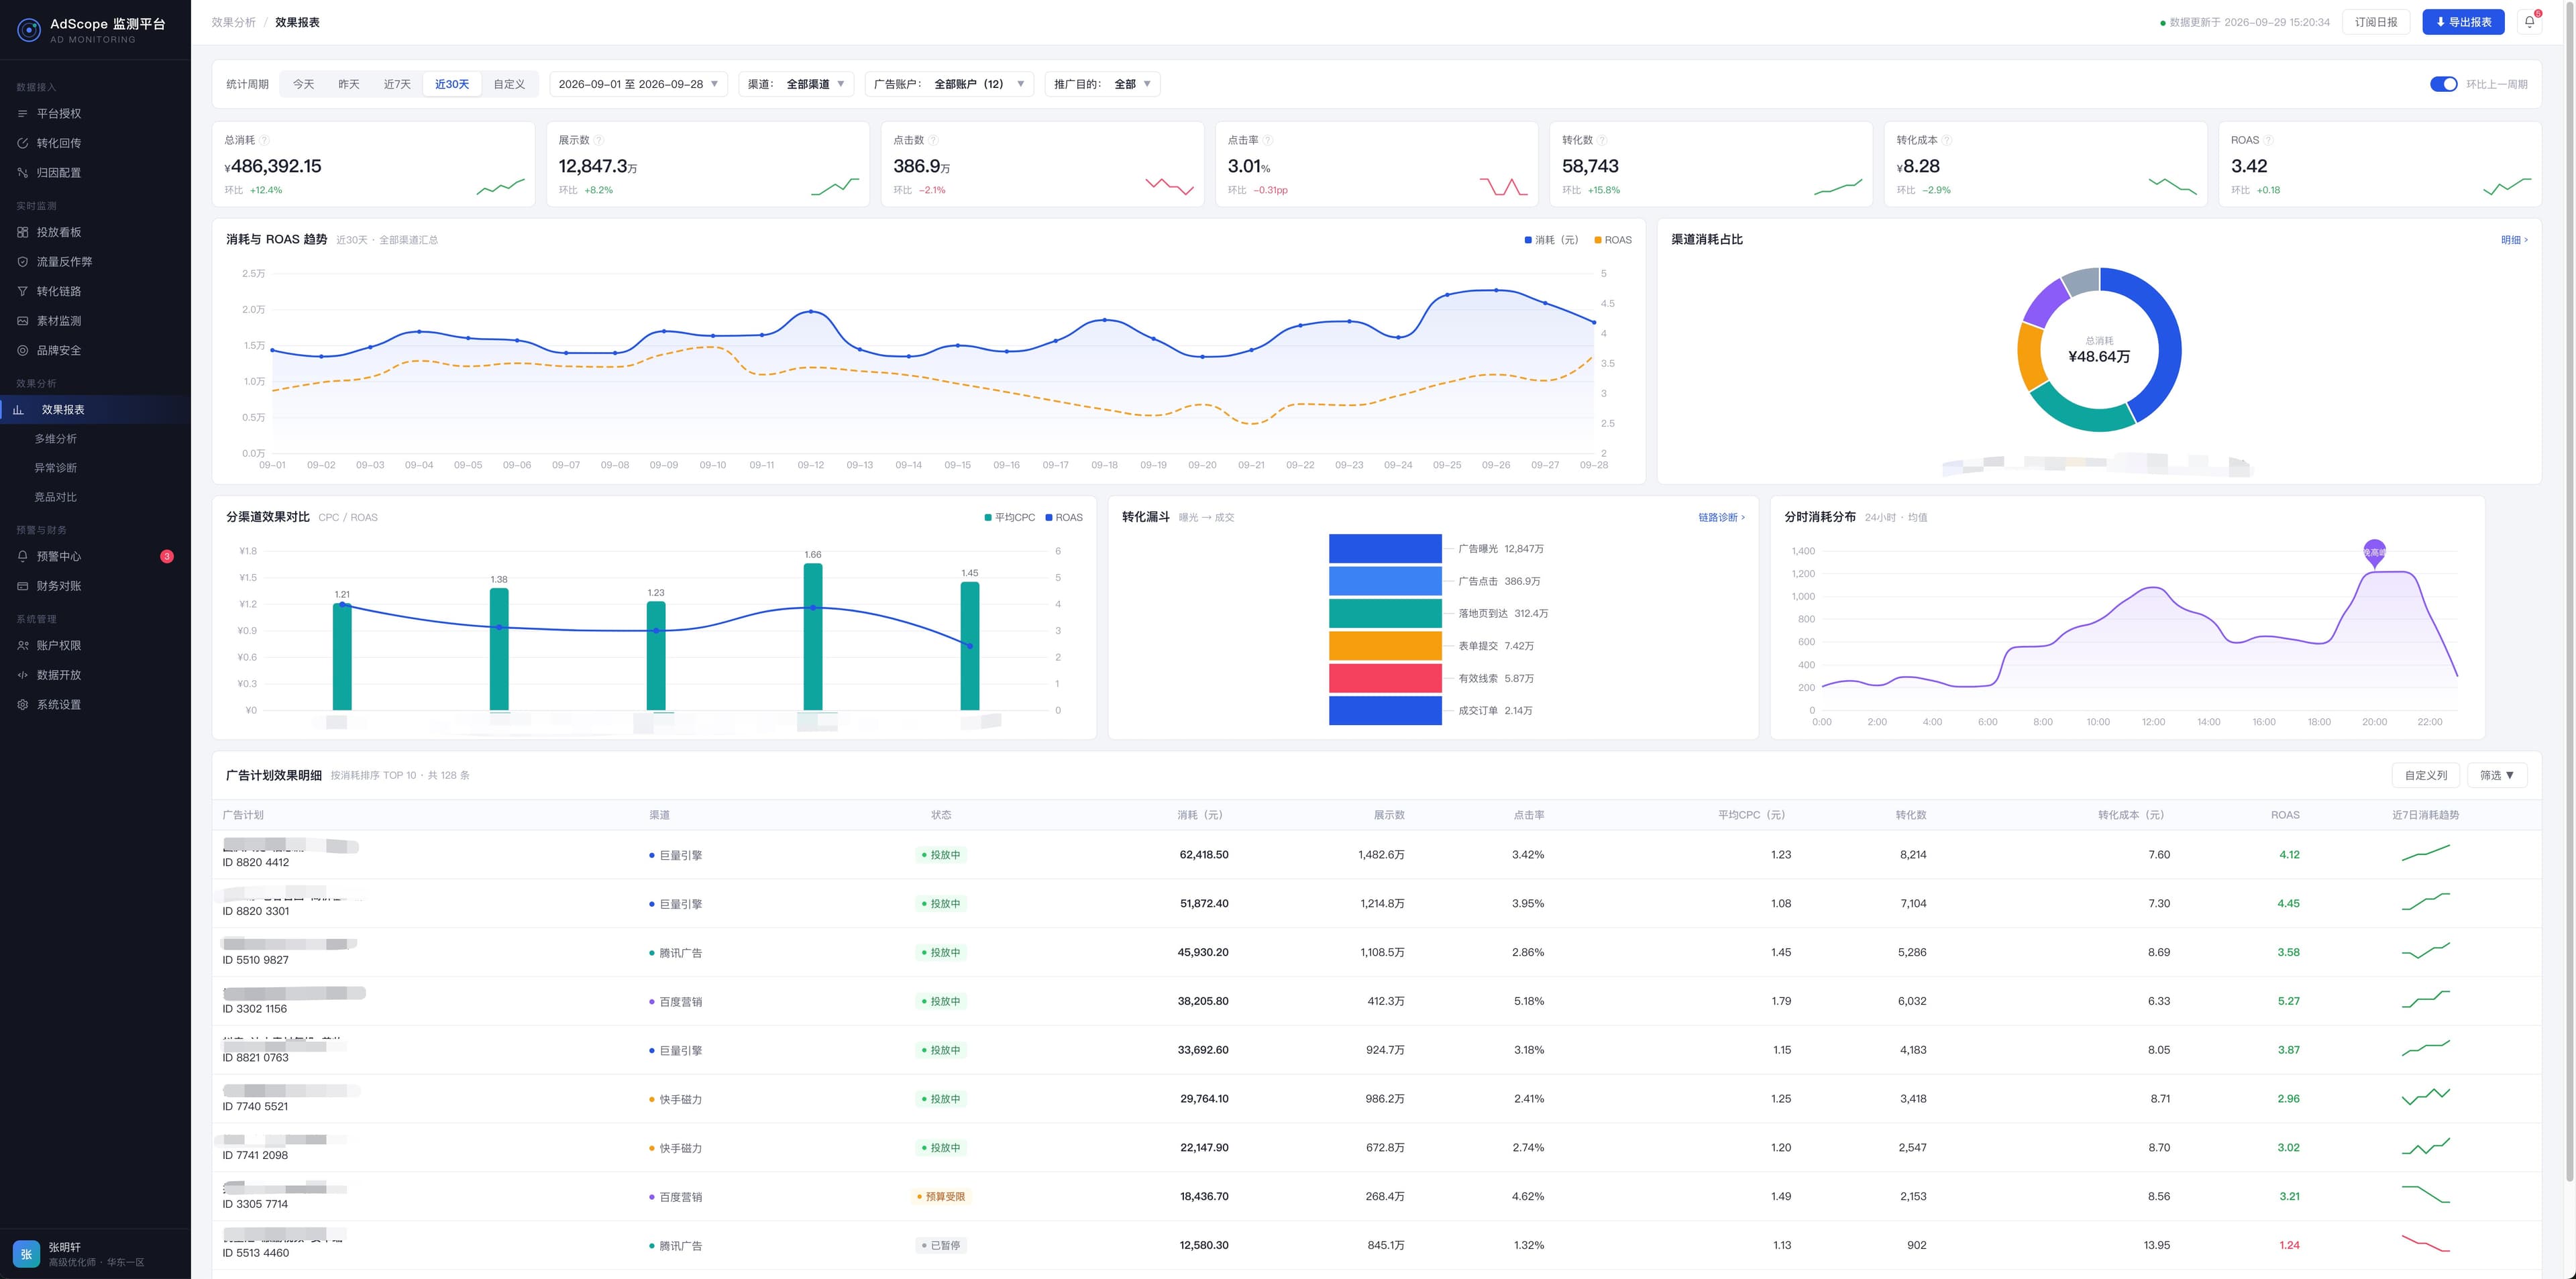
广告效果监控大屏:消耗与 ROAS 趋势、渠道效果对比与转化漏斗
数据架构设计
- 设计并实现广告数据仓库,采用星型模型构建多维分析体系,支持亿级数据秒级查询
- 构建实时数据处理管道,基于 Storm + Kafka 实现广告日志实时清洗和 ETL,延迟<5s
- 开发多维度分析模型,覆盖广告订单、位置、地域、创意、终端等核心维度
指标体系建设
- 构建广告效果评估体系,包含曝光、点击、转化、留存等 30+ 核心指标
- 开发用户行为分析模型,实现视频广告完播率、多周期留存等高级指标
- 设计实时指标计算框架,支持千万级 UV 聚合计算,准确率 99.9%
监控平台开发
- 设计双维度监控体系,整合业务指标和系统性能的实时监控
- 基于 Grafana 开发可视化监控平台,实现多域名服务质量和异常请求的实时监测
- 构建智能告警系统,支持多维度异常检测和及时预警
构建企业级广告投放数据分析平台,为商业化团队提供全方位的数据洞察和决策支持,实现广告投放效果的精准评估和优化。
项目成果
- 平台日均处理广告数据 500GB+,支持 100+ 位商业化人员的日常运营决策
- 通过实时数据反馈,帮助广告运营团队提升投放效率 40%,广告转化率提升 35%
- 监控系统有效降低广告投放异常处理时间 60%,服务可用性提升至 99.99%
技术栈
实时计算:Kafka, Storm数据存储:Hive, ClickHouse, Redis监控告警:Grafana, Prometheus, AlertManager开发语言:Java, Python, SQL
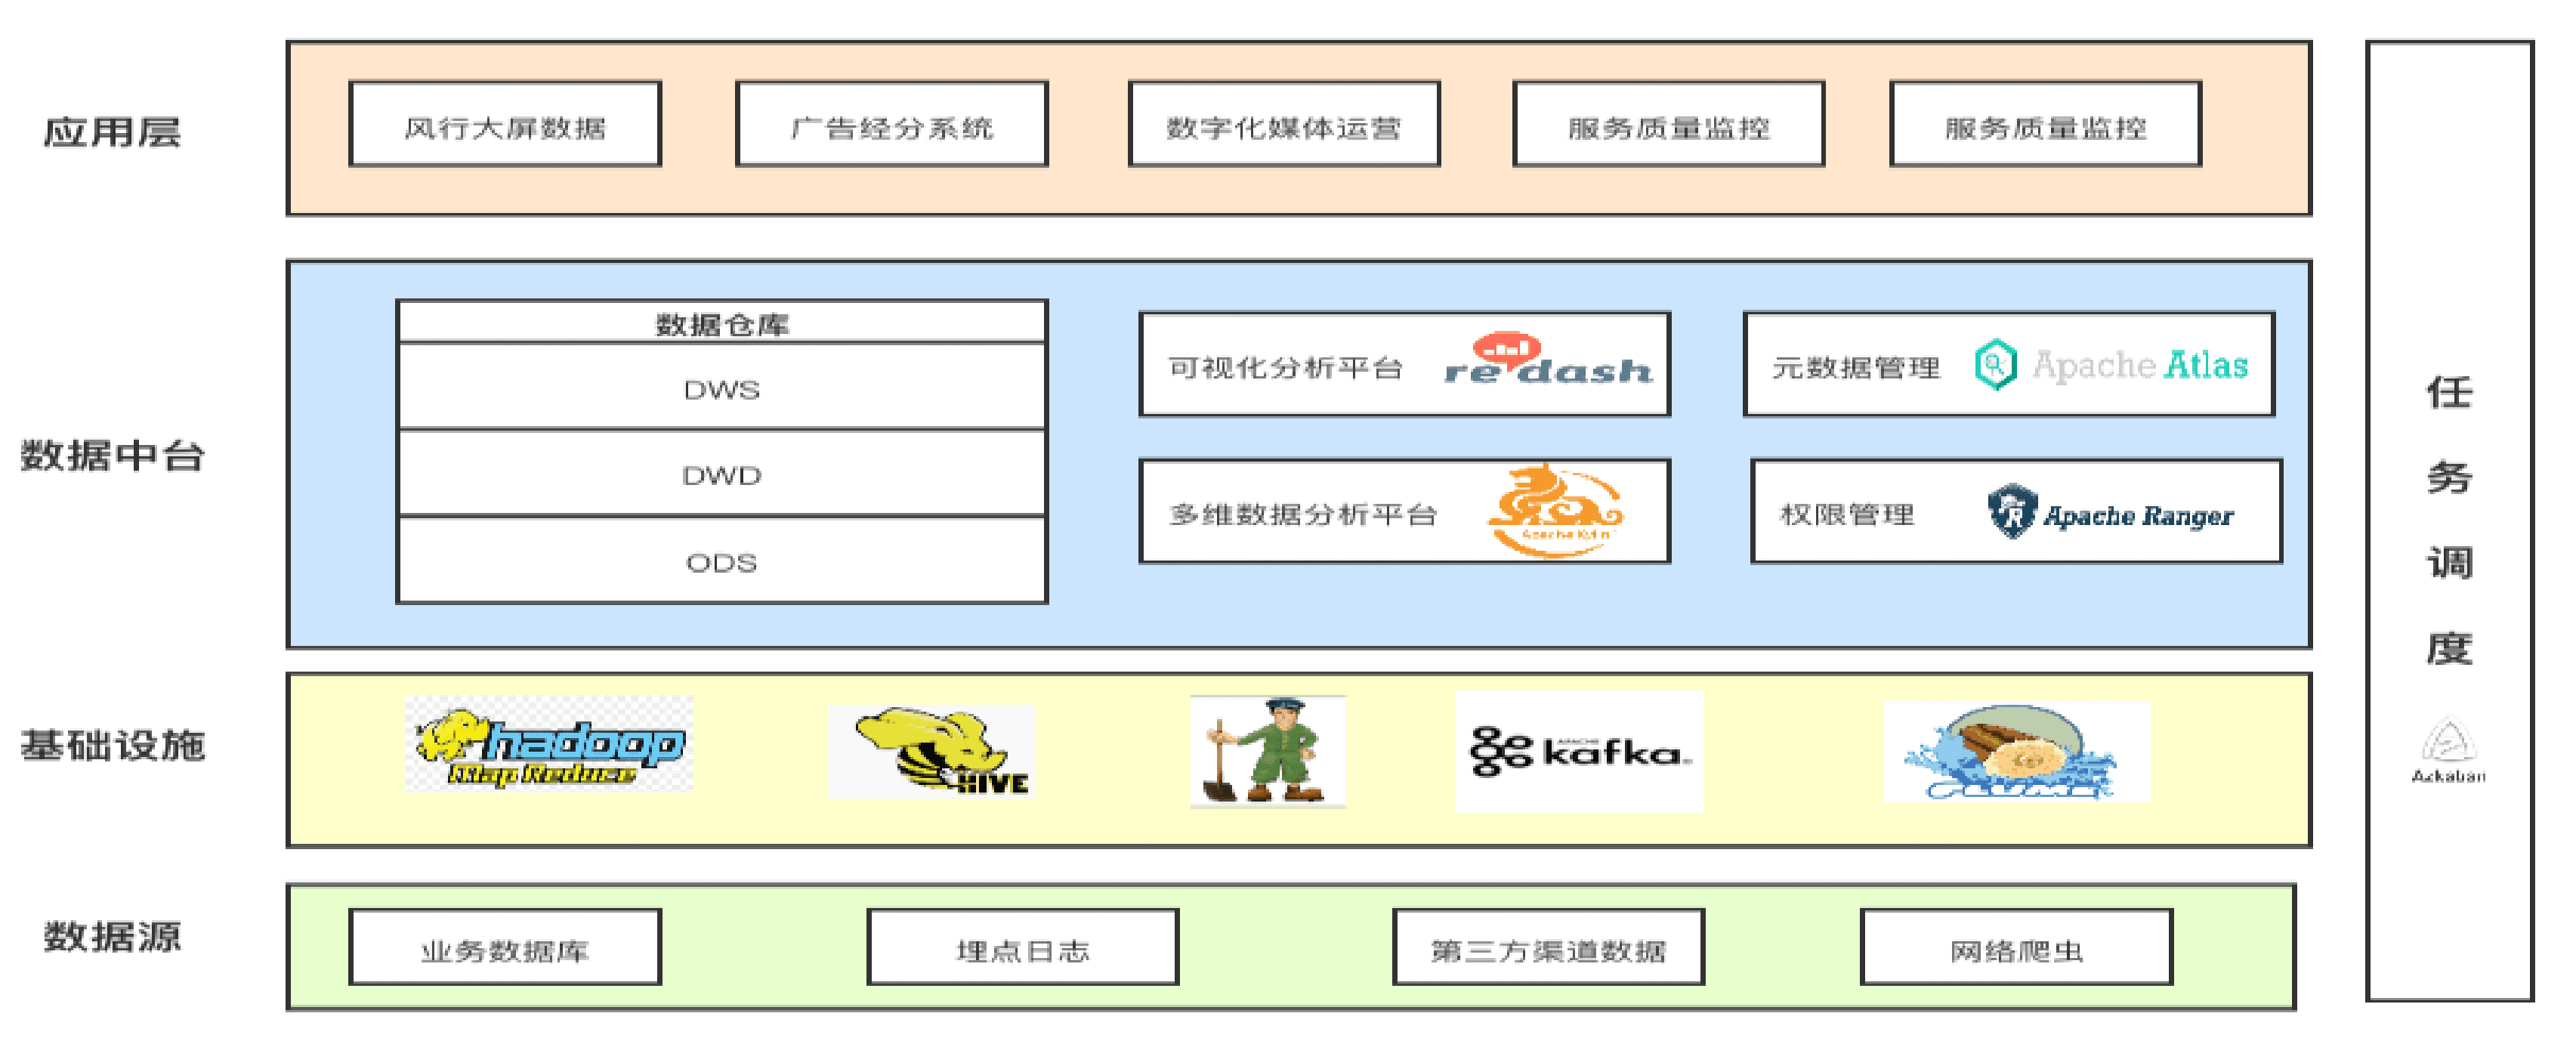
数据中台系统架构图
中台架构设计
- 设计一站式数据中台架构,集成多维数据分析、元数据管理、数据质量和数据安全等核心功能
- 构建统一的数据服务层,实现数据资产的标准化管理和高效复用
- 设计数据开发规范,建立数据质量评估体系,确保数据的准确性和及时性
核心功能实现
- 开发 OLAP 分析引擎,支持亿级数据的即席查询,查询延迟优化至秒级
- 实现元数据管理系统,包含数据地图和血缘分析,支持数据资产全生命周期管理
- 构建数据质量监控体系,通过规则引擎实现数据质量的自动化检测和预警
平台运营管理
- 制定数据服务 SLA,建立需求响应机制,提升数据服务效率
- 推动数据资产的统一管理和共享,降低重复开发成本
- 建立数据安全管理体系,实现数据访问权限的精细化控制
通过数据中台建设提升数据服务能力,支撑公司数字化转型战略,实现数据资产的统一管理和价值复用。
项目成果
- 数据需求响应时间从小时级优化至分钟级,服务效率提升 80%
- 通过数据复用和自助分析,降低数据开发成本 60%
- 数据质量达标率提升至 99%,数据服务可用性达到 99.9%
技术栈
数据分析:ClickHouse, Presto, Kylin元数据管理:Atlas, DataHub质量监控:Griffin开发语言:Java, Python, Shell
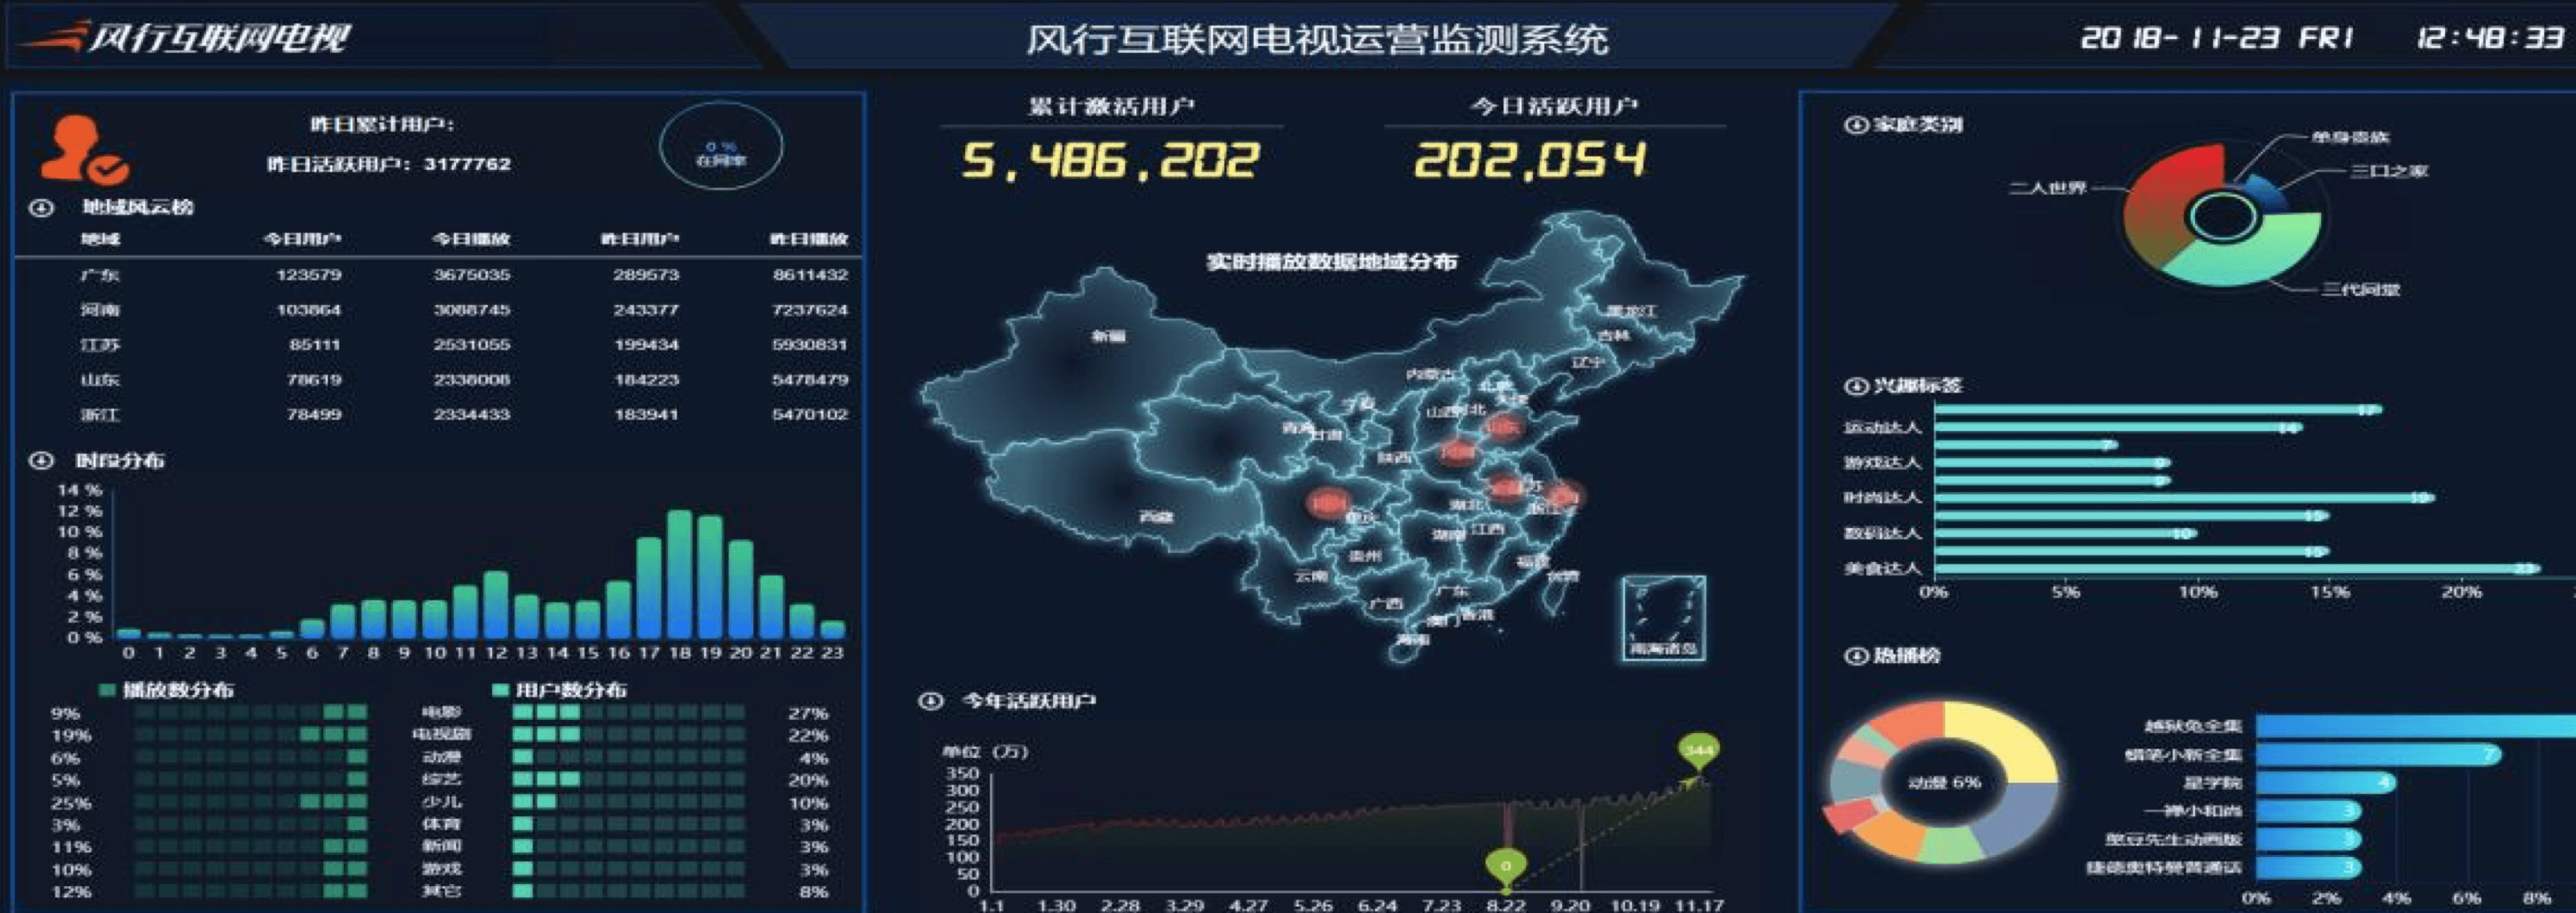
风行数据大屏展示界面
架构设计
- 基于数据中台设计实时数据服务架构,实现毫秒级数据更新
- 采用微服务架构设计后端系统,确保系统的可扩展性和可维护性
- 设计多层缓存机制,优化数据加载性能和用户体验
数据处理
- 基于 Flink + Kafka 构建实时计算链路,处理实时业务数据
- 设计数据聚合策略,实现多维度数据的实时统计和分析
- 实现数据异常检测和自动恢复机制,确保数据的准确性
前端实现
- 使用 Vue 开发前端应用,确保代码的可维护性
- 基于 ECharts 5.0 实现多样化的数据可视化效果
- 实现主题切换功能,支持多种展示场景
打造面向公众的数据可视化平台,实时展示公司核心业务指标,提供直观的数据展示和交互体验。
项目成果
- 系统支持同时展示 50+ 核心业务指标,数据更新延迟 < 1s
- 可视化大屏在多个重要场合成功展示,获得领导层高度认可
- 系统稳定性达到 99.99%,支持 7*24 小时持续运行
技术栈
前端:Vue3, ECharts后端:SpringBoot, WebSocket, Redis实时计算:Flink, Kafka监控告警:Prometheus, Grafana
-- table: skill_matrix
技能专长
开发技能
- -精通 Java、Python 等后端开发语言
- -掌握 Docker、K8s 等容器化技术
- -熟悉 TypeScript、Next.js 等前端技术
- -熟练使用 Git、Airflow 等开发工具
数据架构与平台
- -精通 Hadoop、Spark、Flink 等大数据计算框架
- -精通数据仓库模型设计(Data Vault、维度建模)
- -熟悉 dbt、DataX 等数据开发与集成工具,OpenMetadata 元数据平台
- -熟悉数据质量管理体系建设、元数据、数据血缘管理
- -熟悉 Grafana + Prometheus 监控体系、数据安全和隐私保护策略
AI 与 Agent 开发
- -掌握 LLM 应用开发:Prompt Engineering、RAG、Function/Tool Calling
- -掌握 Agent 架构设计,实践基于 Skill + 工作流编排的数据开发 Agent
- -完成数据治理 Agent PoC:元数据自动标注、血缘/影响分析、智能问数(Text-to-SQL)
- -熟悉 Dify、Coze 等 AI 应用平台,深度使用 AI 编程工具提升研发效率
团队管理
- -熟练掌握敏捷开发与项目管理方法
- -具备良好的沟通能力和团队协作精神
- -擅长技术团队建设与管理,提升团队效率与士气
- -具备数据业务价值分析能力,善于数据价值挖掘与变现
-- table: summary
个人评价
- -深度参与业务决策,擅长将数据价值转化为业务增长
- -多年技术团队管理经验,建立了完善的数据开发规范与技术评审机制
- -具备跨部门沟通协调能力,推动数据驱动的组织文化建设
-- table: education
教育背景
北京航空航天大学
经济管理学院工商管理硕士主要课程:管理经济学 / 组织行为学 / 企业战略管理 / 商业数据分析 / 财务管理
北京信息科技大学
计算机与自动化系工学学士主要课程:数据结构与算法 / 计算机网络 / 操作系统 / 数据库系统 / 软件工程
-- table: contact_channels